
最も人気のある 2D レンダラーより 2〜4 倍速いレンダラーを作るまで
spryte は debuff の中で動いているレンダラーで、今では MIT ライセンスのスタンドアロンパッケージになっています。デスクトップ Chrome の 2dbench では、動くスプライトを PixiJS 8 より 2〜4 倍速く描画します。PixiJS 8 は Web で最も広く使われている 2D レンダラーです。しかも起動時に読み込む JavaScript は約 9 分の 1 です(brotli で 10.1 kB 対 87.8 kB)。
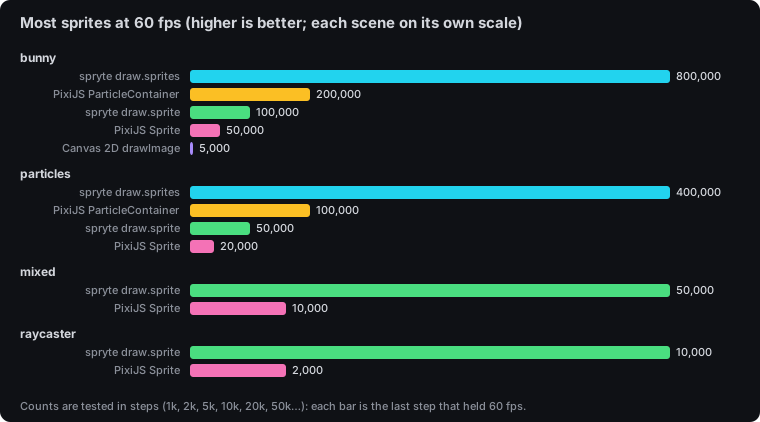
2dbench はオープンです。誰でも実行でき、自分のデバイスの結果を投稿できます。どのライブラリも、計測の前にピクセル単位で同一のフレームを描画し、各ライブラリのセットアップは結果の中に記録されています。PixiJS をもっと速くできるなら、ぜひプルリクエストを送ってください。どちらに転んでも新しい数字を公開します。
ここまで来られたのは、何か一つの裏技のおかげではありません。一つひとつ可能性を絞り込んでいく計測の連鎖と、その後に作った「自分たちをだませない」ベンチマークのおかげです。この記事では、最初のプロファイルから決め手となった 8 バイトのインスタンス形式まで、その流れをたどります。
出発点
spryte は @debuffjp/core の WebGL2 レンダラーとして始まりました。当時からすでにインスタンシングを使うマルチテクスチャのバッチャーで、すべてのスプライトは GPU バッファの中の1つのインスタンスであり、1 回の描画呼び出しで最大 8 枚のテクスチャをバインドし、ホットパスでは一切メモリを確保しません。bunnymark ではテストに使ったノート PC で約 100,000 スプライトを 60 fps で保っていました。PixiJS の Sprite の約 2 倍ですが、PixiJS の ParticleContainer よりは遅かったのです。
問題はその理由と、spryte を別の種類のライブラリに変えることなく改善できるかどうかでした。
1. 時間がどこに使われているかを計る
私たちのベンチマークは、もともと各フレームを2つの数値に分けていました。GPU 同期の前のメインスレッド時間と、GPU 完了までの合計時間です。200,000 スプライトでは次のようになりました。
| フレーム | メインスレッド | スプライトあたり(CPU) | |
|---|---|---|---|
spryte draw.sprite | 21 ms | 14 ms | 約 70 ns |
PixiJS ParticleContainer | 13 ms | 7 ms | 約 36 ns |
GPU 時間はほぼ同じでした。差はスプライトごとの JavaScript にありました。
2. 推測せず、プロファイルする
最初の推測はマイクロ最適化でした。draw.sprite は呼び出しのたびに "image" in frame をチェックしていて、DOM の画像に対してはこれが長いプロトタイプチェーンをたどることになるので、最後の画像をキャッシュしてみました。ベンチマークはまったく変わりませんでした。
そこで 200k スプライトで CPU プロファイルを取りました。
| 関数 | サンプルの割合 |
|---|---|
Draw.sprite | 26% |
WebGL2Backend.quad | 23% |
GPU 同期(readPixels) | 21% |
コストは呼び出しごとの処理そのものに分散していました。オプションの読み取り、変換の計算、そしてスプライトごとに 13 回のバッファ書き込みです。特に遅い一行があるわけではないので、呼び出しごとの経路を削っても 2 倍の差は埋まりません。構造そのものを変える必要がありました。
3. スプライトごとに JavaScript のコストを払うのをやめる
ParticleContainer が勝つのは、それが一括 API だからです。そこで spryte のイミディエイトモードのスタイルで、一括 API を追加しました。
draw.sprites(frame, positions, count, options);1つのフレームと多数の位置を受け取ります。共通の変換は一度だけ計算し、各コピーはタイトなループで書き込みます。これで spryte は約 200,000 スプライトまで ParticleContainer と互角になりました。
ところが 400,000 になると、spryte はまた遅れを取りました(28 ms 対 18 ms)。今回はメインスレッドの数値は問題なく、増えていたのは GPU 側の割合でした。
4. 本当のボトルネックは帯域幅だった
変わるのは位置だけなのに、各コピーはまだ 52 バイトのインスタンス全体(2×3 行列、UV 矩形、色、フラッシュ、テクスチャユニット)をアップロードしていました。400,000 スプライトでは 1 フレームあたり約 21 MB です。
そこで、各インスタンスが vec2 の位置だけという2つ目の GPU プログラムを追加しました。52 バイトではなく 8 バイトです。共通のもの(変換、UV、色合い、ピクセルスナップ)はすべてユニフォームになり、呼び出しごとに一度だけ送られます。しかもインスタンスデータが位置だけなので、手元にある Float32Array をそのまま bufferData に渡せます。
const positions = new Float32Array(2 * MAX); // 毎フレーム更新する x, y のペア
draw.sprites(spark, positions, live);         // spryte 内でコピーごとの JavaScript は一切なし
結果、200,000 スプライトが 3.8 ms になり、60 fps を 800,000 スプライトまで保てるようになりました。ParticleContainer は 200,000 です。
5. 本物のパーティクルは一粒ずつ変化する
本物のパーティクルはスケール・回転・色がばらばらで、ParticleContainer はそれに対応しています。私たちも、コピーごとの JavaScript がゼロという性質を手放すことなく、コピーごとの配列をオプションで追加しました。
draw.sprites(spark, positions, live, { tint: "#ffd36b" }, { scale, rotation, color });- 各配列は独立した GPU バッファで、そのままアップロードされます。
- 色は
Uint32Arrayの中で0xRRGGBBAAとしてパックされたまま、シェーダー内でビットシフトによって展開されるので、JavaScript がバイトを並べ替えることはありません。 - 渡さなかった配列は定数の頂点属性のデフォルト値(スケール 1、回転 0、白)を読むので、使うものだけをアップロードすれば済みます。
- 頂点シェーダーは
draw.spriteとまったく同じ変換を計算します。
6. 同じものを描いていることを証明する
わずかに違うピクセルを描く高速パスはバグです。私たちは本物の GPU(ヘッドレス Chrome)で動くチェックを書きました。シーンを素直な方法(ループの中で sprite())と高速な方法の両方で描き、すべてのピクセルを比較します。各チェックは、わざと壊した実装で失敗することを確認済みです。
このチェックは本物のバグを見つけました。コピーごとの回転を使うと、回転がたまたまゼロだったコピーはピクセルスナップされていなかったのです。sprite() ならスナップしていたはずです。最初、この 25 ピクセルの差は許容範囲内の浮動小数点ノイズに見えました。ところが、差は WebGL2 と Canvas 2D でまったく同じでした。浮動小数点ノイズならそうはなりません。つまり決定的な原因があるということで、それを突き止めて修正しました。許容値はゼロに戻りました。
7. ズルのしにくいベンチマーク
最初の比較は、レンダラーごとに1回ずつ実行しただけのものでした。数字に説得力を持たせるため、ベンチマークを作り直しました。
- ラウンドの交互実行。 複数のラウンドを、ラウンドごとにレンダラーの順番をずらしながら実行し、中央値と最小〜最大の範囲を報告します。
- ピクセル一致ゲート。 計測の前に、すべてのレンダラーが同じシードのフレームを 2,000 と 50,000 スプライトで描画します。描画面積が基準と 0.5% を超えて異なるか、スプライトの内部でピクセルが異なれば、その実行は失敗です。「内部」とは両方のフレームで 3×3 の近傍が単色であることを指すので、ライブラリごとに丸め方が正当に異なるエッジは数えません。一方、色合い・アルファ・テクスチャの誤りは数えます。この指標は検証済みで、PixiJS にわざと間違った色合いを与えると 0% から 22% に上がりました。
- 環境の自動記録。 電源と電源プランも含みます。以前は「デフォルトの電源プラン」と手でメモしていたのですが、実際にはノート PC は Turbo になっていました。今はランナーが検出します。
- 同じ条件同士の比較。
draw.spriteはSpriteと、draw.spritesはParticleContainerと比べます。どちらもニアレストフィルタリング、アンチエイリアスなし、整数ピクセルへの丸め(PixiJS ではroundPixels: true)です。
8. 敵対的レビュー
公開する前に、3つの独立したレビューで結果を崩しにかかってもらいました。
ベンチマークに偏りはないか? レビュアーは、動的なシーンのすべてのプロパティ(スケール、色合い、アルファ、回転)が時間とともに変化し、どのライブラリもキャッシュで処理を省けないことを確かめました。そのルールのもとで、spryte は動的パーティクルで 3.8 倍、混在スプライトで 3.3 倍リードしています。また、PixiJS のセットアップが最速のものであることも確認しました。ここでは WebGPU レンダラーのほうが WebGL レンダラーより遅く、roundPixels にはコストがなく、アトラスを使っても意味のある差は出ません。
spryte は壊れないか? 6つのエッジケースが見つかり、0.1.1 でそれぞれテスト付きで修正しました。シェーダーのコンパイル失敗、大きすぎる count、クリップ後の Canvas 2D のスムージング、大きすぎるレンダーターゲット、NaN の count、そして dispose() 後の描画です。新しいチェックでは本物の GPU コンテキストロストを強制的に起こし、次のフレームが新しく作ったレンダラーのものとピクセル単位で同一であることを確認しています。
公開した主張は正しいか? このサイトのすべての数字は、コミット済みの結果ファイルかビルド出力までたどれます。サイズ計測の仕組みもリポジトリにあります。
結果
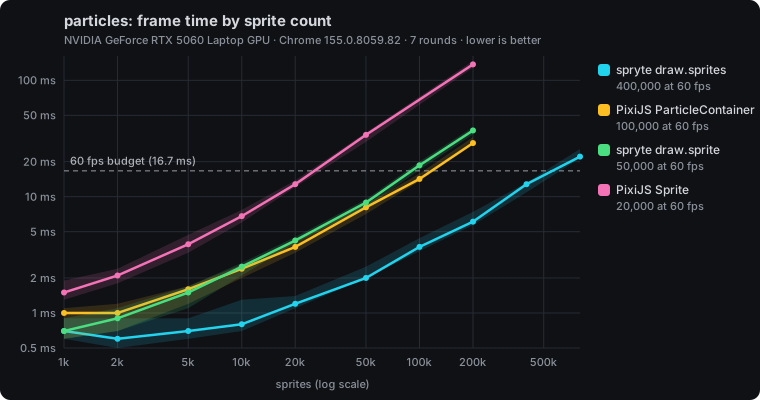
同じマシン、同じアセット、同じシミュレーション、交互実行 3 ラウンド、ピクセル一致ゲート通過済みの結果です。
| ワークロード | spryte | PixiJS 8 | spryte は |
|---|---|---|---|
| 動的パーティクル(パーティクルごとにすべてが変化)、200k | 7.7 ms | 28.9 ms(ParticleContainer) | 3.8 倍速い |
| 回転・スケール・色合い・アルファが変化するスプライト、テクスチャ 4 枚、50k | 9.8 ms | 32.3 ms(Sprite) | 3.3 倍速い |
| Bunnymark、スプライトごとに 1 回呼び出し、50k | 5.8 ms | 16.4 ms(Sprite) | 2.8 倍速い |
| Bunnymark、一括、200k | 4.4 ms | 8.9 ms(ParticleContainer) | 2.0 倍速い |
| 起動時の JS | 10.1 kB | 87.8 kB | 約 9 分の 1 |
NVIDIA RTX 5060 Laptop GPU、AMD Ryzen 7 260、Chrome 155、AC 電源、電源プラン Turbo。生データ、手法、注意事項はベンチマークにあります。
まだ示せていないこと
- スマートフォンはほとんど未検証。 今のところ手元にあるのは iOS 26 の iPhone 1 台だけで、短いラウンドを1回、iOS の 1 ms のタイマー分解能で計っただけです。あくまで参考値です。そこでは、一般的なスプライト(50k で約 3.6 倍)と動的パーティクル(200k で約 2.3 倍)では spryte のリードが保たれました。位置だけの一括描画では、PixiJS の
ParticleContainerが互角になりました(200k で 12 ms 対 13 ms)。JavaScript ではなく GPU のピクセルフィルレートが限界になる場面なので、予想通りです。何かを結論づける前に、特にミドルレンジの Android を中心に、もっと多くのデバイスで試したいと考えています。 - ほかのワークロード。 タイルマップ、テキストの多い UI、クリッピング、レンダーターゲットとシェーダー、オブジェクトの生成と破棄、メモリ、読み込み時間はまだ計測していません。
- ほかのレンダラー。 PixiJS は誰もが知る基準ですが、唯一の存在ではありません。
最後の点こそ、私たちが 2dbench を作った理由です。どんな 2D Web レンダラーでも小さなアダプターで参加できるオープンなベンチマークです。次は Phaser、KAPLAY、Excalibur、LittleJS、three.js の予定です。特徴は次の通りです。
- 共通のシード付きシミュレーションが1つだけあり、すべてのライブラリが同一の処理を行います。
- 同じピクセル一致ゲートを使い、基準は私たち自身のコードではなく、現王者の PixiJS
Spriteです。 - 統計手法は、決めつけではなくばらつき調査から選んでいます。
- 結果は環境情報をすべて含めて記録されます。
スマートフォンなら誰でも debuffjp.github.io/2dbench/mobile.html で実行でき、結果を GitHub の issue で投稿できます。それをワークフローが検証済みのプルリクエストに変換します。コミュニティの結果にまだ載っていないデバイスをお持ちなら、ぜひ実行してみてください。
2dbench の軽いシミュレーションでは、各フレームのより多くの部分がレンダラーに回るので、差はさらに広がり、動的パーティクルで約 4.7 倍になります。上の数字は控えめなほうです。
教訓
- 最適化の前にプロファイルする。 コストは薄く広がっていたので、構造を変える以外に動かす方法はありませんでした。
- 本当のボトルネックの種類を見つける。 最初は呼び出しごとの JavaScript、次はアップロードの帯域幅。どちらもマイクロチューニングでは解決しません。
- 高速パスには自分で証明させる。 本物の GPU 上で、失敗するところを見たことのあるチェックを使い、素直な経路とピクセルを比較します。
- ズルのしにくいベンチマークにする。 共通のシミュレーション、ピクセルゲート、すべてのプロパティの変化、そしてすべての数字と一緒に公開される手法。
試してみてください:npm install spryte。API リファレンスとベンチマークの手法はこのサイトにあり、コードは github.com/debuffjp/spryte にあります。